KI auf dem Gerät
Der lokale KI-Motor, mit Vulkan auf der GPU der BC-250 beschleunigt — Unsloth Studio, mit GGUF-Modellen von Hugging Face.
SkillFishOS bringt eine lokale KI mit: Modelle zum Chatten und zum Programmieren laufen vollständig auf der GPU der BC-250, ohne Cloud, nichts verlässt das Gerät. Ein Klick schaltet sie ein und aus, damit GPU und Arbeitsspeicher wieder frei sind, wenn du spielen willst.
Warum Vulkan und nicht ROCm
Der „offizielle“ Rechenunterbau von AMD ist ROCm, aber er unterstützt das gfx1013 der BC-250 nicht. Deshalb verwendet SkillFishOS den Vulkan-Unterbau mit den Mesa/RADV-Treibern: er nutzt die eingebaute GPU und den gemeinsamen Speicher voll aus (mit erweiterter GTT, siehe GPU).
Wie viel das ausmacht. Auf der Platine mit Qwen3-1.7B Q4_K_M gemessen:
| nur CPU | GPU über Vulkan | ||
|---|---|---|---|
| Erzeugung | 41,5 Token/s | 210,7 Token/s | 5,1× |
| Verarbeitung der Eingabe | 9,2 Token/s | 157,2 Token/s | 17× |
Der Motor: Unsloth Studio
Seit 26.08 ist der Motor Unsloth Studio, an Stelle des früheren Gespanns aus Ollama und OpenWebUI in Docker. Es ist ein einziger nativer Dienst, der sowohl das Chatfenster als auch eine zu OpenAI kompatible Schnittstelle bereitstellt und auf 127.0.0.1:8888 lauscht.
Was sich in der Praxis ändert:
- Ein Dienst statt eines Docker-Gespanns. Früher brauchte es drei Container (Ollama, OpenWebUI, Dockge) und ein eigenes Abbild von rund 6,5 GB; jetzt ist es nur noch
skillfish-unsloth.service. - Die Modelle kommen von Hugging Face. Unsloth holt GGUF-Dateien unmittelbar aus dem vollständigen Katalog von Hugging Face statt aus einer ausgewählten Liste, die Auswahl an Modellen und Quantisierungen ist damit ungleich größer — samt der Fassungen, die das Unsloth-Team selbst veröffentlicht.
- Von sich aus antwortet er nur dem eigenen Rechner. Von außen erreicht man ihn über den Remote Manager, der sich über PAM anmeldet. Sollen auch die anderen Geräte im Haus ihn nutzen, gibt es im KI-Bereich einen Schalter, der ihn für das lokale Netz öffnet, mit eigenem Benutzer und eigenem Passwort.
Die Modelle
Die Modelle sind GGUF-Dateien aus dem Katalog von Hugging Face und kommen aus zwei Quellen: aus dem Bereich KI des Control Center, wo du den Namen des Repositorys eingibst (zum Beispiel unsloth/Qwen3-4B-GGUF) und die Variante aus der Liste mit den Größen wählst; oder aus dem Hub in Unsloth Studio, der die Suche und die vollständigen Modellseiten hat.
Faustregel auf dieser Platine: die 16 GB GDDR6 teilen sich System und GPU, also bleibt man besser unter etwa 11 GB Gewichten, damit für den Rest Luft bleibt.
Einschalten, aktualisieren, Schlüssel
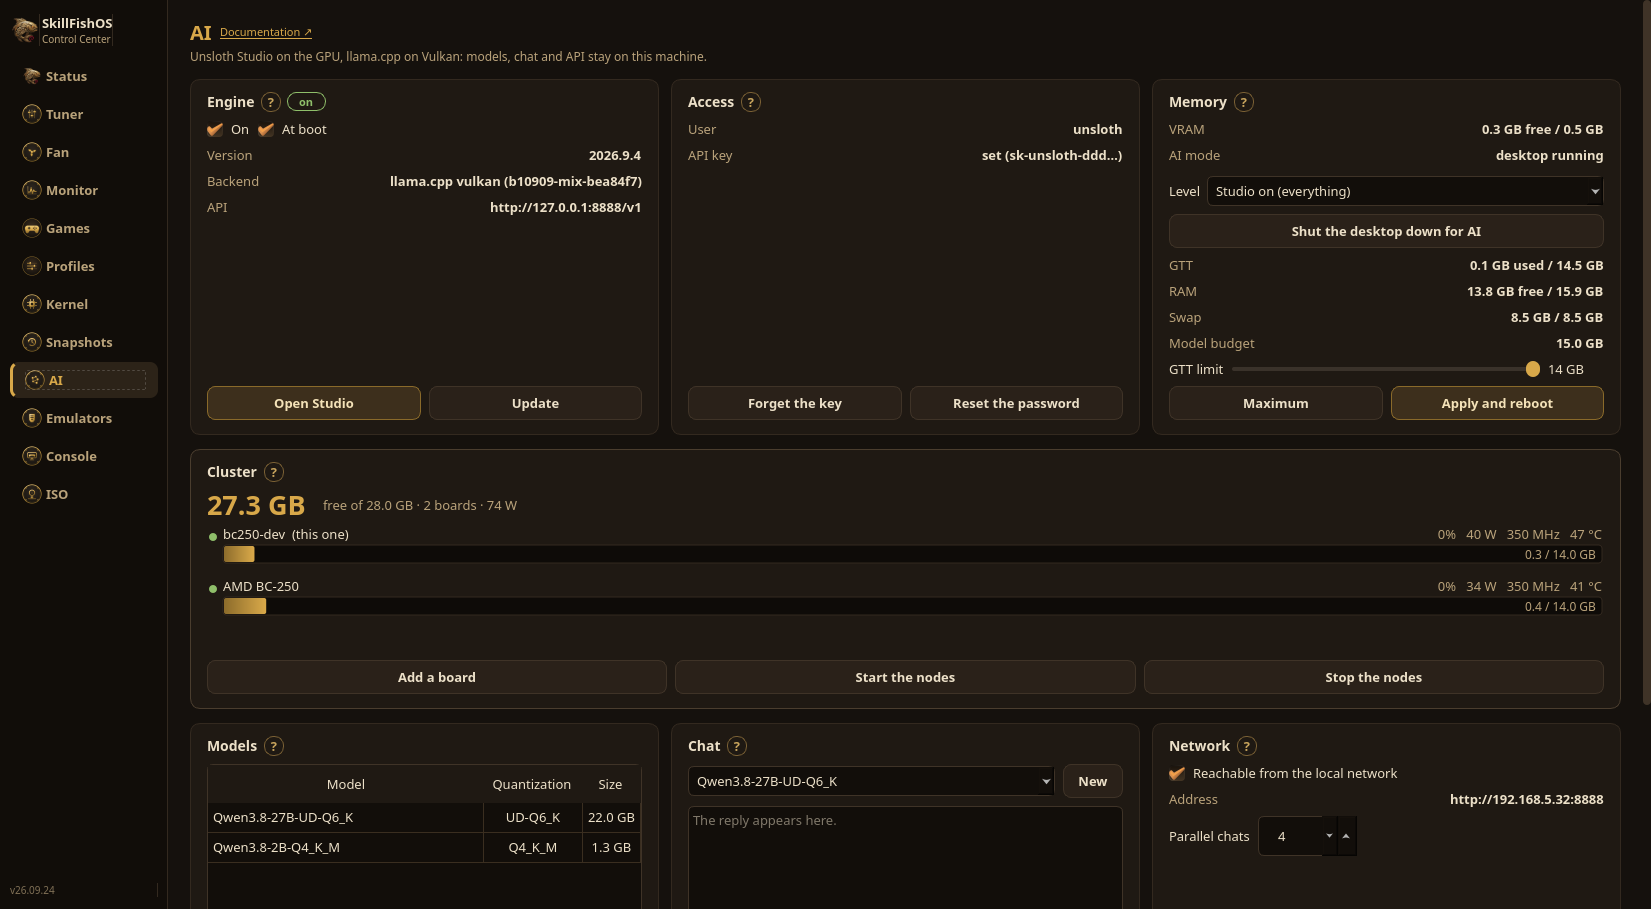
Der Bereich KI des Control Center startet und stoppt den Motor, schaltet ihn beim Systemstart ein und zeigt die Version mit der Aktualisierung in einem Klick. Dasselbe steht im Remote Manager, im Browser.
Unsloth erzeugt bei der Installation ein zufälliges Passwort und schaltet sich nach einer Stunde selbst ab, wenn es nicht geändert wird. Diesen Schritt erledigt der KI-Bereich: du wählst das Studio-Passwort, und der API-Schlüssel entsteht dabei. Über den Schlüssel sprechen das Fenster und der Remote Manager mit dem Motor; die Modelle auf der Platte, der Speicher (VRAM, GTT, RAM, Swap) und ein Chat-Test mit den gemessenen Token pro Sekunde stehen daneben.
Denk daran:
- KI und Spiele gehören nicht gleichzeitig benutzt: sie teilen sich dieselbe GPU und denselben Speicher;
- mit ausgeschaltetem Motor stehen GPU und RAM wieder ganz zum Spielen bereit.
Dem Modell mehr Speicher geben
Der Schreibtisch belegt Speicher, den das Modell gebrauchen könnte. Im KI-Bereich fährt man ihn herunter und wählt dabei auch, wie viel heruntergeht: Studio an, also nur der Schreibtisch; nur der Motor, mit Webseite; nur der Motor, nur Schnittstelle, was llama-server allein auf Port 8888 zurücklässt, mit derselben Schnittstelle und demselben Schlüssel wie zuvor. Auf einer Karte mit geladenem Modell gemessen: aus 567 MB Systemspeicher werden 115.
Von da an steuert man die Maschine über den Remote Manager von einem anderen Rechner aus oder über ssh. Das Modell für den nackten Motor wählt man vorher, in derselben Karte.
Mehr als eine Karte
Mehrere BC-250 teilen sich ein Modell, das für eine allein zu groß ist. Die Karte Cluster führt die Karten auf, wie viel Speicher sie zusammen haben und wie viel sie gerade ziehen, und schaltet die Knoten ein und aus. Ein 27B mit 22 GB lädt auf einer einzelnen Karte gar nicht erst; auf zweien läuft es mit 7,57 Token pro Sekunde.
Dafür ist es da, und das gehört klar gesagt: schneller wird es nicht. Ein Modell, das auf eine Karte passte, verliert beim Aufteilen rund ein Drittel seiner Geschwindigkeit, denn jede Grenze zwischen Schichten geht über das Netz. Der Verbund ist für die Modelle, die allein überhaupt nicht laufen.
Quellen
- Unsloth · llama.cpp · Hugging Face
- Mesa / RADV (Vulkan-Treiber)
- ROCm — unterstützte Hardware (
gfx1013steht nicht auf der Liste)