IA en el propio equipo
El motor de IA local, acelerado con Vulkan en la GPU de la BC-250 — Unsloth Studio, con modelos GGUF de Hugging Face.
SkillFishOS trae una IA local: modelos de conversación y de programación funcionando enteramente en la GPU de la BC-250, sin nube, sin que nada salga fuera. Un clic la enciende y la apaga, así que la GPU y la memoria quedan libres otra vez cuando quieres jugar.
Por qué Vulkan y no ROCm
El conjunto de cómputo «oficial» de AMD es ROCm, pero no soporta el gfx1013 de la BC-250. Por eso SkillFishOS usa el motor Vulkan con los controladores Mesa/RADV: aprovecha del todo la GPU integrada y la memoria compartida (con el GTT ampliado, ver GPU).
Cuánto importa. Medido en la placa con Qwen3-1.7B Q4_K_M:
| solo CPU | GPU con Vulkan | ||
|---|---|---|---|
| Generación | 41,5 tok/s | 210,7 tok/s | 5,1× |
| Procesado del texto de entrada | 9,2 tok/s | 157,2 tok/s | 17× |
El motor: Unsloth Studio
Desde la 26.08 el motor es Unsloth Studio, que sustituye al anterior montaje de Ollama + OpenWebUI en Docker. Es un único servicio propio que ofrece tanto la ventana de chat como una API compatible con la de OpenAI, escuchando en 127.0.0.1:8888.
Lo que cambia en la práctica:
- Un servicio en lugar de un montaje de Docker. Antes hacían falta tres contenedores (Ollama, OpenWebUI, Dockge) más una imagen propia de unos 6,5 GB; ahora es solo
skillfish-unsloth.service. - Los modelos vienen de Hugging Face. Unsloth descarga archivos GGUF directamente del catálogo completo de Hugging Face y no de un registro seleccionado, así que la variedad de modelos y de cuantizaciones es muchísimo mayor — incluidas las compilaciones que publica el propio equipo de Unsloth.
- Por su cuenta responde solo a la propia máquina. Desde fuera se llega a él por el Remote Manager, que autentica con PAM. Si quieres que responda también a los demás dispositivos de casa, la sección IA tiene un interruptor que lo abre a la red local, con su propio usuario y contraseña.
Los modelos
Los modelos son archivos GGUF del catálogo de Hugging Face, y se descargan desde dos sitios: la sección IA del Control Center, escribiendo el nombre del repositorio (por ejemplo unsloth/Qwen3-4B-GGUF) y eligiendo la variante de la lista, con los tamaños; o el Hub dentro de Unsloth Studio, que tiene la búsqueda y las fichas completas.
Regla práctica en esta placa: los 16 GB de GDDR6 se comparten entre sistema y GPU, así que conviene quedarse por debajo de unos 11 GB de pesos para dejar aire al resto.
Encendido, actualización y clave
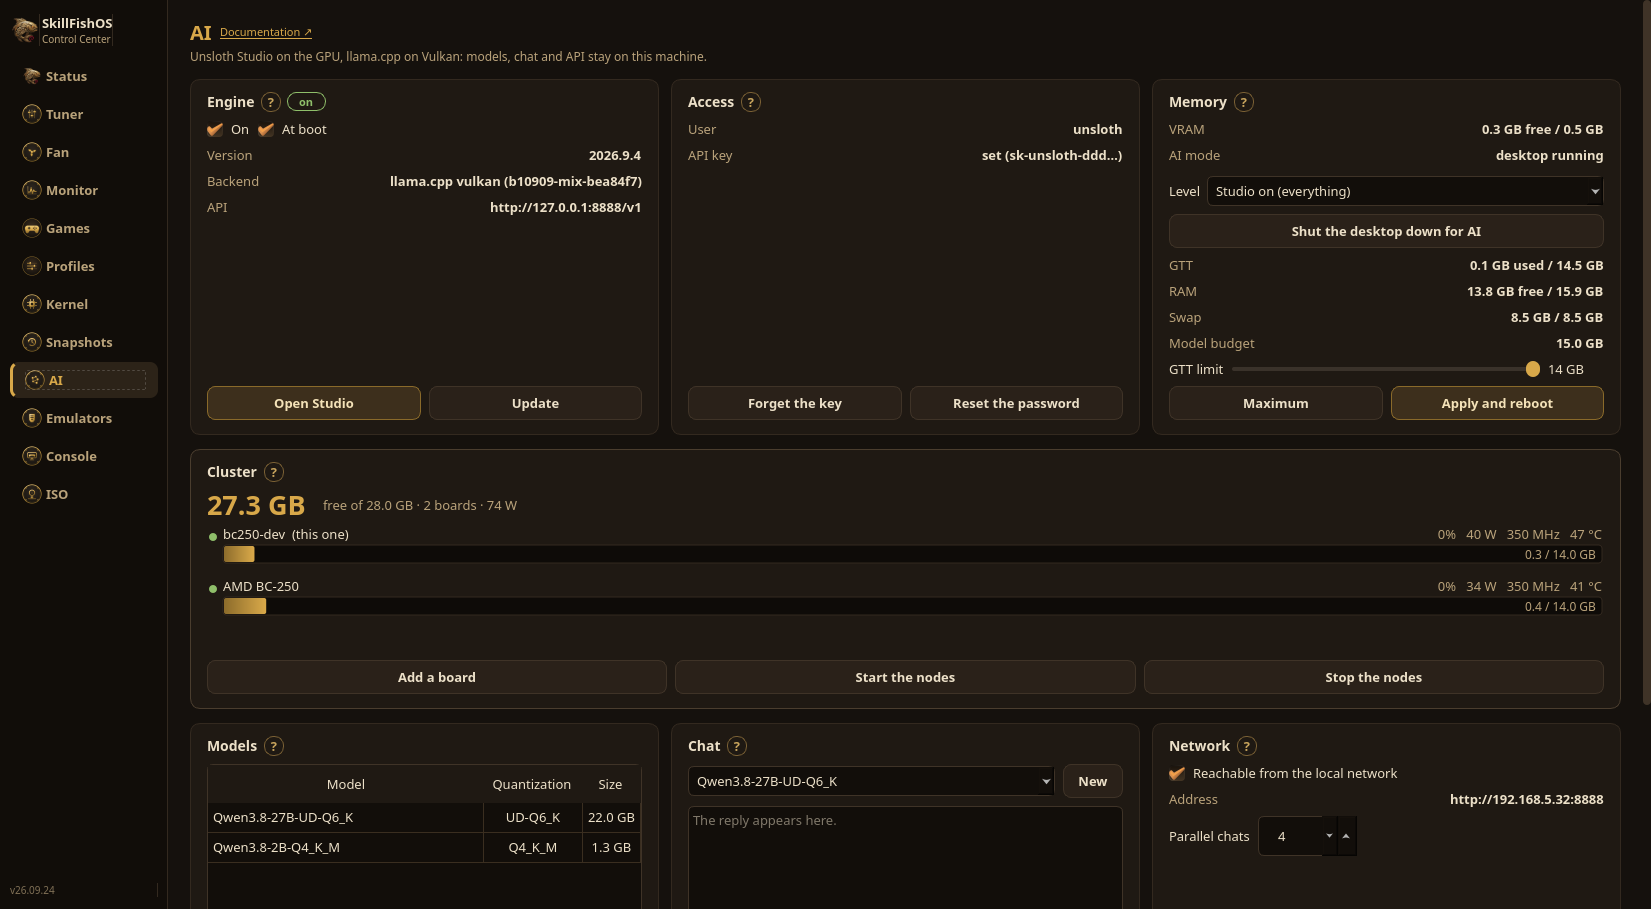
La sección IA del Control Center enciende y apaga el motor, lo habilita al arrancar y muestra la versión con la actualización en un clic. Lo mismo está en el Remote Manager, desde el navegador.
Unsloth genera una contraseña al azar al instalarse, y se apaga solo al cabo de una hora si no se cambia. Ese paso lo hace la sección IA: eliges la contraseña de Studio y la clave API se crea a la vez. La clave es como la ventana y el Remote Manager hablan con el motor; los modelos en disco, la memoria (VRAM, GTT, RAM, swap) y una prueba de chat con los tokens por segundo medidos están al lado.
Ten en cuenta que:
- IA y juegos no se usan a la vez: comparten la misma GPU y la misma memoria;
- con el motor apagado, GPU y RAM vuelven a estar del todo disponibles para jugar.
Darle más memoria al modelo
El escritorio ocupa memoria que el modelo podría usar. Desde la sección IA se apaga, y también se elige cuánto apagar: Studio encendido, es decir solo el escritorio; solo el motor, con página web; solo el motor, solo API, que deja llama-server a solas en el puerto 8888, con la misma API y la misma clave de antes. Medido en una placa con un modelo cargado: 567 MB de memoria de sistema pasan a 115.
A partir de ahí la máquina se maneja desde el Remote Manager de otro ordenador, o por ssh. El modelo del motor desnudo se elige antes, en la misma tarjeta.
Más de una placa
Varias placas BC-250 se reparten un modelo demasiado grande para una sola. La tarjeta Cluster enumera las placas, cuánta memoria tienen juntas y cuánto están consumiendo, y enciende y apaga los nodos. Un 27B de 22 GB en una sola placa ni siquiera se carga; en dos funciona a 7,57 tokens por segundo.
Para eso sirve, y conviene decirlo claro: no va más rápido. Un modelo que sí cabía en una placa pierde alrededor de un tercio de su velocidad al repartirlo, porque cada frontera entre capas viaja por la red. El clúster es para los modelos que por sí solos no arrancan.
Fuentes
- Unsloth · llama.cpp · Hugging Face
- Mesa / RADV (controlador Vulkan)
- ROCm — hardware compatible (
gfx1013no está en la lista)