IA no próprio aparelho
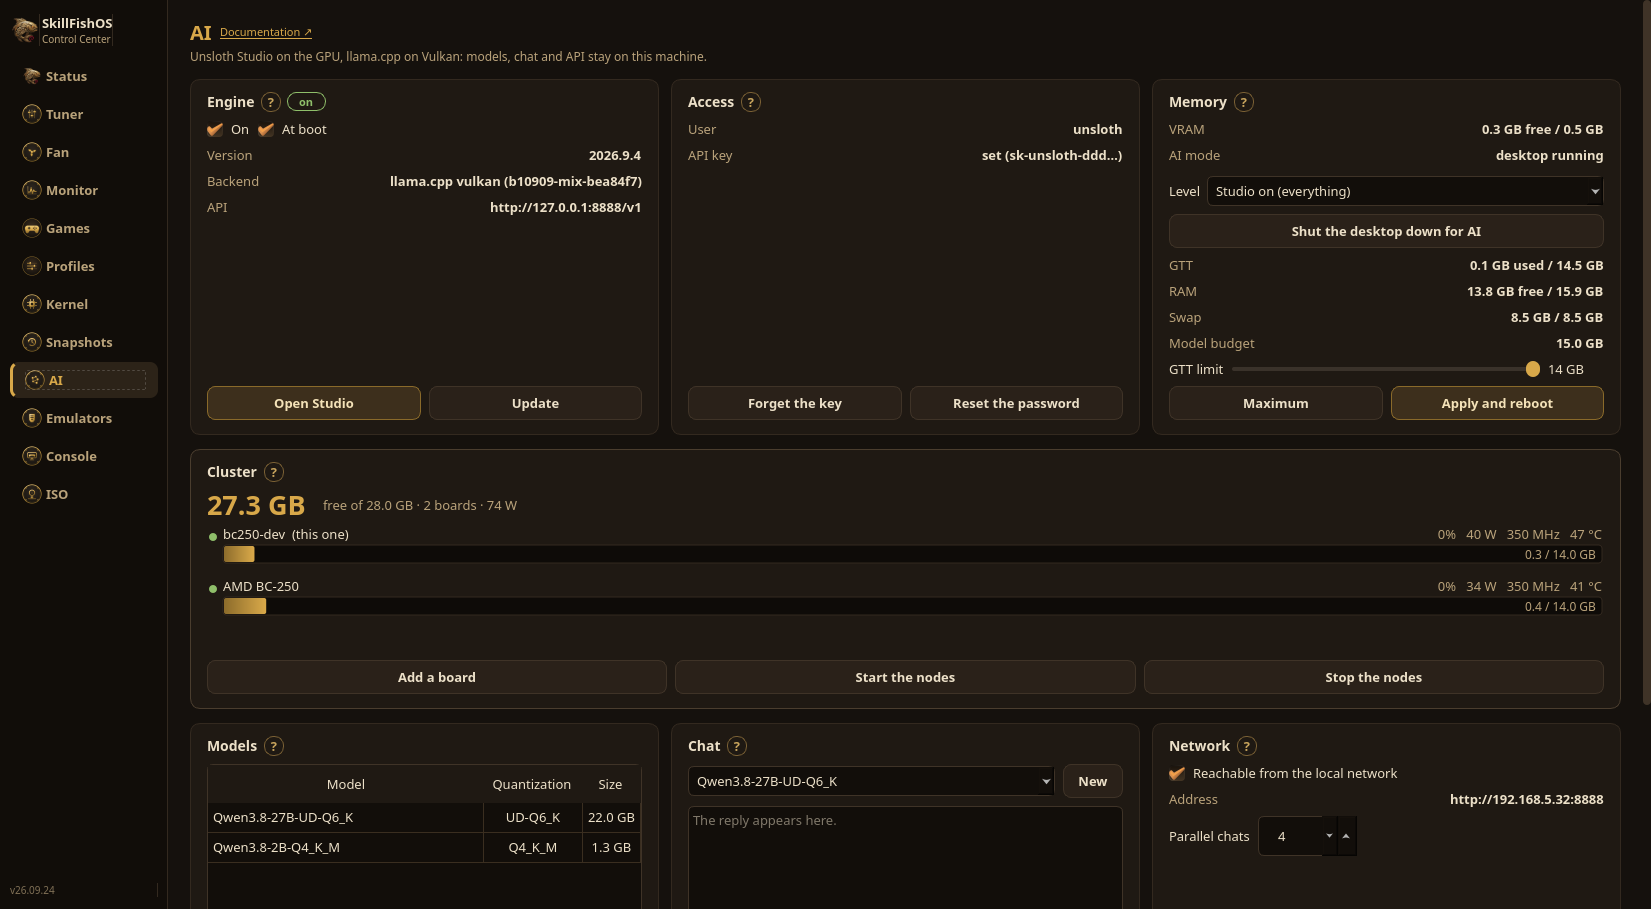
O motor de IA local, acelerado por Vulkan na GPU da BC-250 — Unsloth Studio, com modelos GGUF do Hugging Face.
O SkillFishOS traz uma IA local: modelos de conversa e de programação rodando inteiramente na GPU da BC-250, sem nuvem, sem nada saindo para fora. Um clique liga e desliga, então a GPU e a memória ficam livres de novo quando você quer jogar.
Por que Vulkan e não ROCm
O conjunto de computação “oficial” da AMD é o ROCm, mas ele não dá suporte ao gfx1013 da BC-250. Por isso o SkillFishOS usa o motor Vulkan com os drivers Mesa/RADV: ele aproveita por completo a GPU integrada e a memória compartilhada (com o GTT ampliado, veja GPU).
O quanto isso pesa. Medido na placa com o Qwen3-1.7B Q4_K_M:
| só CPU | GPU por Vulkan | ||
|---|---|---|---|
| Geração | 41,5 tok/s | 210,7 tok/s | 5,1× |
| Processamento do texto de entrada | 9,2 tok/s | 157,2 tok/s | 17× |
O motor: Unsloth Studio
Desde a 26.08 o motor é o Unsloth Studio, no lugar do antigo conjunto Ollama + OpenWebUI em Docker. É um único serviço nativo que oferece tanto a janela de conversa quanto uma API compatível com a da OpenAI, escutando em 127.0.0.1:8888.
O que muda na prática:
- Um serviço em vez de um conjunto de Docker. Antes eram três contêineres (Ollama, OpenWebUI, Dockge) mais uma imagem própria de uns 6,5 GB; agora é só o
skillfish-unsloth.service. - Os modelos vêm do Hugging Face. O Unsloth baixa arquivos GGUF direto do catálogo completo do Hugging Face, e não de um registro selecionado, então a variedade de modelos e quantizações é muito maior — incluindo as compilações que a própria equipe do Unsloth publica.
- Por si só responde apenas à própria máquina. De fora chega-se a ele pelo Remote Manager, que autentica por PAM. Se quiseres que responda também aos outros dispositivos de casa, a secção IA tem um interruptor que o abre à rede local, com o seu próprio utilizador e palavra-passe.
Os modelos
Os modelos são ficheiros GGUF do catálogo da Hugging Face, e chegam de dois sítios: a secção IA do Control Center, onde escreves o nome do repositório (por exemplo unsloth/Qwen3-4B-GGUF) e escolhes a variante da lista, com os tamanhos; ou o Hub dentro do Unsloth Studio, que tem a pesquisa e as fichas completas.
Regra prática nesta placa: os 16 GB de GDDR6 são partilhados entre sistema e GPU, por isso convém ficar abaixo dos ~11 GB de pesos para deixar espaço ao resto.
Ligar, atualizar e a chave
A secção IA do Control Center liga e desliga o motor, ativa-o no arranque e mostra a versão com a atualização num clique. O mesmo está no Remote Manager, pelo navegador.
O Unsloth gera uma senha ao acaso quando se instala, e desliga-se sozinho ao fim de uma hora se essa senha não for mudada. Esse passo é feito pela secção IA: escolhes a senha do Studio e a chave API é criada com ela. A chave é como a janela e o Remote Manager falam com o motor; os modelos em disco, a memória (VRAM, GTT, RAM, swap) e um teste de chat com os tokens por segundo medidos ficam ao lado.
Tem em conta que:
- IA e jogos não se usam juntos: partilham a mesma GPU e a mesma memória;
- com o motor desligado, GPU e RAM voltam a estar totalmente disponíveis para jogar.
Dar mais memória ao modelo
O ambiente de trabalho ocupa memória que o modelo poderia usar. Na secção IA desliga-se, e escolhe-se também quanto desligar: Studio ligado, ou seja só o ambiente de trabalho; só o motor, com página web; só o motor, só API, que deixa o llama-server sozinho na porta 8888, com a mesma API e a mesma chave de antes. Medido numa placa com um modelo carregado: 567 MB de memória de sistema passam a 115.
Daí em diante a máquina comanda-se pelo Remote Manager de outro computador, ou por ssh. O modelo do motor nu escolhe-se antes, no mesmo cartão.
Mais do que uma placa
Várias placas BC-250 repartem um modelo grande demais para uma só. O cartão Cluster lista as placas, quanta memória têm juntas e quanto estão a consumir, e liga e desliga os nós. Um 27B de 22 GB numa só placa nem sequer carrega; em duas corre a 7,57 tokens por segundo.
É para isso que serve, e convém dizê-lo com clareza: não fica mais rápido. Um modelo que cabia numa placa perde cerca de um terço da velocidade quando é repartido, porque cada fronteira entre camadas viaja pela rede. O cluster é para os modelos que sozinhos não correm de todo.
Fontes
- Unsloth · llama.cpp · Hugging Face
- Mesa / RADV (driver Vulkan)
- ROCm — hardware suportado (o
gfx1013não está na lista)