Lokalna AI
Lokalny silnik AI, przyspieszany Vulkanem na grafice BC-250 — Unsloth Studio z modelami GGUF z Hugging Face.
SkillFishOS ma w zestawie lokalną AI: modele do rozmowy i do kodu działające w całości na grafice BC-250, bez chmury, bez wysyłania czegokolwiek na zewnątrz. Jedno kliknięcie włącza je i wyłącza, więc grafika i pamięć wracają do dyspozycji, gdy chcesz zagrać.
Dlaczego Vulkan, a nie ROCm
„Oficjalnym” stosem obliczeniowym AMD jest ROCm, ale nie obsługuje on gfx1013 z BC-250. SkillFishOS używa więc backendu Vulkan ze sterownikami Mesa/RADV: wykorzystuje w pełni zintegrowaną grafikę i współdzieloną pamięć (z rozszerzonym GTT, zobacz GPU).
Ile to znaczy w praktyce. Zmierzone na płycie z Qwen3-1.7B Q4_K_M:
| Sam procesor | Grafika przez Vulkan | ||
|---|---|---|---|
| Generowanie | 41,5 tok/s | 210,7 tok/s | 5,1× |
| Przetwarzanie zapytania | 9,2 tok/s | 157,2 tok/s | 17× |
Silnik: Unsloth Studio
Od wydania 26.08 silnikiem jest Unsloth Studio, który zastąpił wcześniejszy dockerowy zestaw Ollama + OpenWebUI. To jedna natywna usługa dająca zarówno interfejs rozmowy, jak i API zgodne z OpenAI, nasłuchująca na 127.0.0.1:8888.
Co się przez to zmienia:
- Jedna usługa zamiast zestawu kontenerów. Wcześniej potrzeba było trzech kontenerów (Ollama, OpenWebUI, Dockge) plus własnego obrazu na ~6,5 GB; teraz jest to po prostu
skillfish-unsloth.service. - Modele przychodzą z Hugging Face. Unsloth pobiera pliki GGUF wprost z pełnego katalogu Hugging Face, a nie z wybranego rejestru, więc wachlarz dostępnych modeli i kwantyzacji jest nieporównanie szerszy — łącznie z tym, co publikuje sam zespół Unsloth.
- Sam z siebie odpowiada tylko tej maszynie. Z zewnątrz dociera się do niego przez Remote Manager, który uwierzytelnia przez PAM. Jeśli chcesz, by odpowiadał też innym urządzeniom w domu, w sekcji AI jest przełącznik otwierający go na sieć lokalną, z własnym użytkownikiem i hasłem.
Modele
Modele to pliki GGUF z katalogu Hugging Face i pochodzą z dwóch miejsc: z sekcji SI Control Center, gdzie wpisujesz nazwę repozytorium (na przykład unsloth/Qwen3-4B-GGUF) i wybierasz wariant z listy, z rozmiarami; albo z Hubu w Unsloth Studio, który ma wyszukiwarkę i pełne karty modeli.
Praktyczna zasada na tej płycie: 16 GB GDDR6 dzieli system z GPU, więc lepiej zostać poniżej ~11 GB wag, żeby reszcie zostało miejsce.
Włączanie, aktualizacja i klucz
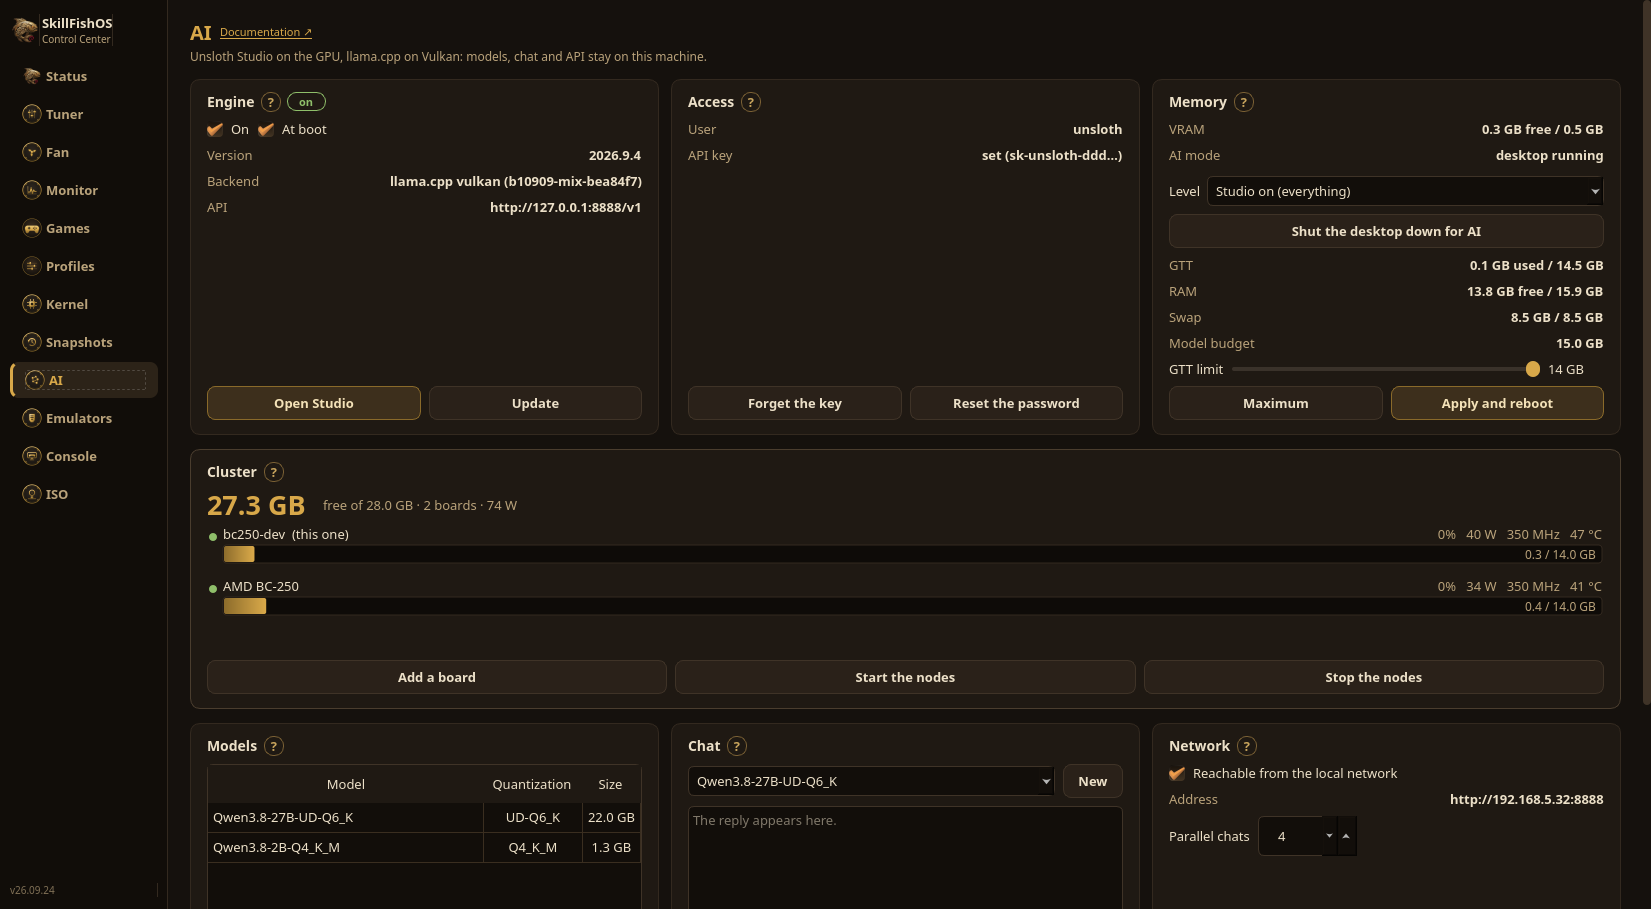
Sekcja SI w Control Center włącza i wyłącza silnik, włącza go przy starcie i pokazuje wersję z aktualizacją jednym kliknięciem. To samo jest w Remote Managerze, z przeglądarki.
Unsloth przy instalacji tworzy losowe hasło i wyłącza się sam po godzinie, jeśli hasło nie zostanie zmienione. Ten krok wykonuje sekcja SI: wybierasz hasło do Studio, a klucz API powstaje razem z nim. Kluczem okno i Remote Manager rozmawiają z silnikiem; modele na dysku, pamięć (VRAM, GTT, RAM, swap) i próbny czat ze zmierzonymi tokenami na sekundę są obok.
Pamiętaj, że:
- SI i gry nie chodzą razem: dzielą to samo GPU i tę samą pamięć;
- przy wyłączonym silniku GPU i RAM wracają w całości do grania.
Więcej pamięci dla modelu
Pulpit zajmuje pamięć, której mógłby użyć model. W sekcji AI się go wyłącza, a także wybiera, ile ma zejść: Studio włączone, czyli sam pulpit; tylko silnik, ze stroną; tylko silnik, samo API, co zostawia llama-server sam na porcie 8888, z tym samym API i tym samym kluczem. Zmierzone na płycie z wczytanym modelem: 567 MB pamięci systemu zamienia się w 115.
Od tej chwili maszyną steruje się z Remote Managera na innym komputerze albo przez ssh. Model dla samego silnika wybiera się wcześniej, w tej samej karcie.
Więcej niż jedna płyta
Kilka płyt BC-250 dzieli między siebie model zbyt duży dla jednej. Karta Cluster wypisuje płyty, ile pamięci mają razem i ile pobierają, oraz włącza i wyłącza węzły. 27B o rozmiarze 22 GB na jednej płycie nawet się nie wczyta; na dwóch działa z prędkością 7,57 tokena na sekundę.
Do tego właśnie służy i warto powiedzieć wprost: nie działa szybciej. Model, który mieścił się na jednej płycie, traci około jednej trzeciej prędkości po podzieleniu, bo każda granica między warstwami idzie przez sieć. Klaster jest dla modeli, które same w ogóle nie ruszają.
Źródła
- Unsloth · llama.cpp · Hugging Face
- Mesa / RADV (sterownik Vulkana)
- ROCm — obsługiwany sprzęt (
gfx1013nie ma na liście)